Perplexity AIの検索インデックスと引用の仕組み:AI時代に選ばれるためのGEO戦略
AI検索エンジンである「Perplexity AI(パープレキシティ)」の普及に伴い、従来のSEO(検索エンジン最適化)の概念が大きく変わりつつあります。ユーザーがキーワードを入力すると、Perplexityは単にウェブサイトのリンクを羅列するのではなく、複数の情報源からデータをリアルタイムで収集・要約し、人間が書いたような流暢な回答と「引用元(ソース)」を提示します。
この変化の波に乗り遅れないためには、Perplexity AIがどのように情報をインデックスし、どの基準でWebサイトを「引用」しているのかを深く理解する必要があります。本記事では、Perplexityの検索エンジンの仕組みを徹底解説し、次世代のAI最適化(GEO:Generative Engine Optimization)で競合に勝つための具体的なアプローチをご紹介します。
1. 従来のSEOと何が違う?Perplexityの検索メカニズムの基本
従来のGoogle検索が「キーワードのマッチング」と「バックリンクの数(権威性)」を重視してきたのに対し、Perplexity AIは**「リアルタイムの文脈理解」と「情報の正確な合成(Synthesis)」**を最優先します。
Perplexityの背後にある仕組みは、独自のクローラー(PerplexityBotなど)によるWeb巡回と、主要な商用検索エンジン(Bingなど)のインデックスを組み合わせたハイブリッド型です。ユーザーが質問を投げかけると、以下のプロセスが数秒のうちに実行されます。
- クエリの解釈と意図の把握:ユーザーの質問の背後にある真の意図をLLM(大規模言語モデル)が分析。
- リアルタイム検索の実行:最新のデータベースやWeb全体から関連情報を網羅的に取得。
- 情報のクロスチェックと要約:複数のソースを比較し、矛盾のない正確な情報を文章として生成。
- 引用元の選定と付与:情報の根拠となったサイトへのリンク(引用カード)を明示。
このように、Perplexityは「検索結果の一覧」を見せるのではなく、「検索結果をベースにした回答文」のなかに自分のサイトが組み込まれるかどうかが勝負になります。従来の検索結果で10位であっても、情報の構造や信頼性が高ければ、Perplexityの回答の「トップ引用」を獲得することが可能です。
2. Perplexity AIのインデックスシステムとクローラーの正体
PerplexityがどのようにWebサイトを認識しているのか、そのインデックスの仕組みを見ていきましょう。Perplexityは独自のクローラーである「PerplexityBot」を稼働させていますが、完全にゼロからすべてのWebを巡回しているわけではありません。
主要なインデックスソース
- 自社クローラー(PerplexityBot):新しいコンテンツや高頻度で更新されるページを直接スキャン。
- パートナーシップとサードパーティAPI:Bingをはじめとする既存の大規模検索インデックスを強力に活用。
したがって、Perplexity対策の第一歩は、従来の検索エンジン(特にBingやGoogle)に対する最適化(テクニカルSEO)を完璧に行うことです。クローラーが訪れた際に、サイトの構造やテキストデータがスムーズに読み取れる状態であることが大前提となります。
さらに、Perplexityは「構造化データ(Schema.org)」を非常に好みます。記事の著者は誰か、公開日や更新日はいつか、FAQや商品データのマークアップが正しく行われているサイトほど、AIが情報を正確に抽出・インデックスしやすくなります。
3. どのサイトが引用される?Perplexityの引用アルゴリズムを解剖
Perplexityで自社のWebサイトが引用されるためには、単にインデックスされているだけでは不十分です。LLMが「このソースは信頼できる」「ユーザーの回答に最適だ」と判断する基準が存在します。
| 評価基準 | 従来のSEO(Google) | Perplexity AI(引用の仕組み) |
|---|---|---|
| 評価の単位 | ページ単位・キーワード単位 | 文章の文脈・セクション単位 |
| リンクの役割 | 投票としてのバックリンク(量と質) | 事実確認(ファクトチェック)の根拠としての参照 |
| コンテンツの形式 | 長文、網羅的なキーワード配置 | 簡潔な定義、データ、箇条書き、構造化された事実 |
| 更新頻度 | 定期的なリライトが有利 | リアルタイムの最新データ、時事性の高さが最重要 |
統計データによると、Perplexityで頻繁に引用されるサイトには以下のような共通点があります。
- 情報のファクトベース性:曖昧な表現が少なく、具体的な数値、統計データ、専門的な見解が含まれている。
- コンテキストの明確さ:「〇〇とは何か?」という問いに対して、最初の2〜3文で本質を簡潔に説明している。
- E-E-A-Tの体現:著者情報や専門的なバックグラウンドが明確に記載されているページ。
AIは「要約しやすい文章」を好みます。回りくどい表現や、広告が多く散らばった読みにくいレイアウトのサイトは、LLMのパーシング(解析)プロセスで弾かれやすくなります。
4. 自社の引用状況を可視化する重要性と「GeoCheck.ai」の活用
PerplexityをはじめとするAI検索で自社ブランドや記事がどのように引用されているか、手動で確認するのはほぼ不可能です。ユーザーのプロンプト(質問文)や文脈によって、AIが生成する回答と引用元は刻々と変化するためです。
ここで必要となるのが、AI時代の新しい最適化手法である**GEO(Generative Engine Optimization)**です。
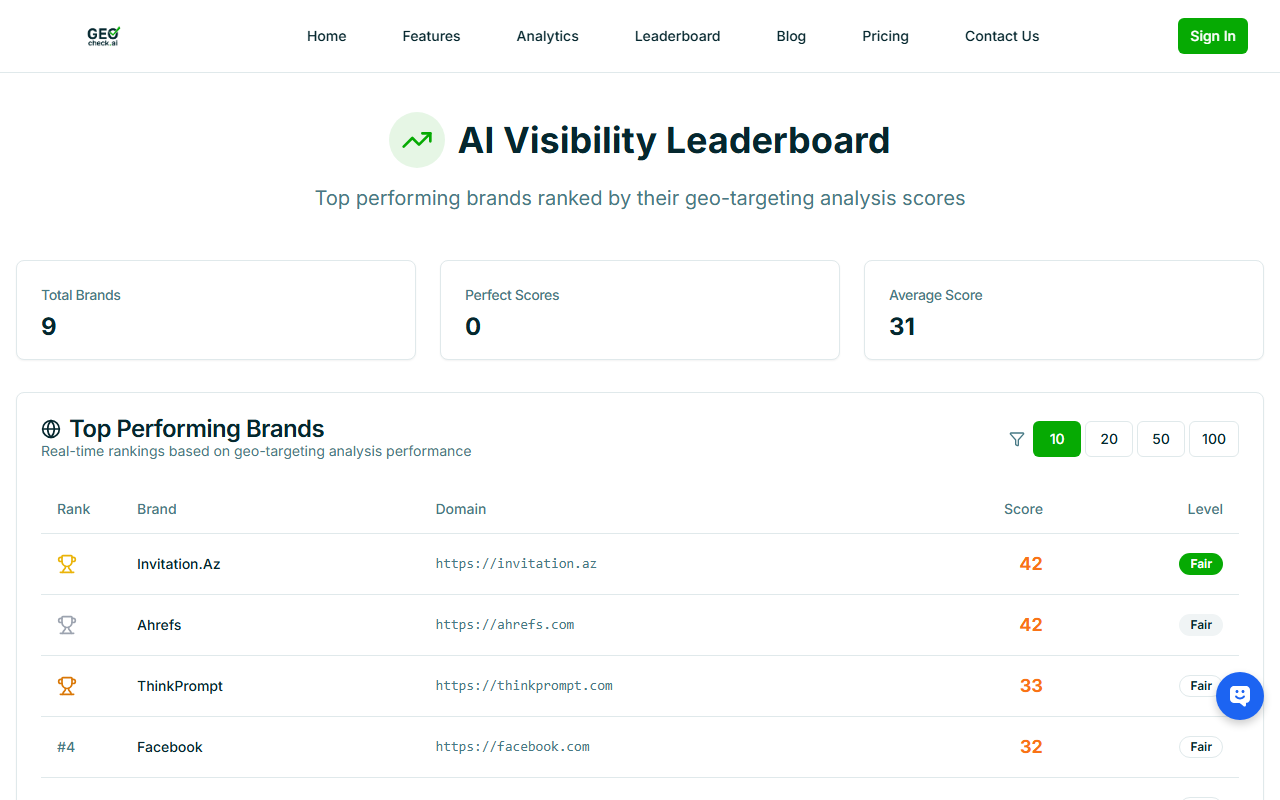
業界をリードするGeoCheck.aiは、Perplexity AIだけでなく、ChatGPT、Gemini、Claude、Grok、DeepSeekといった主要な生成AIエンジン全体における「自社のブランド可視性と引用シェア」を網羅的に監査・測定できる画期的なプラットフォームです。
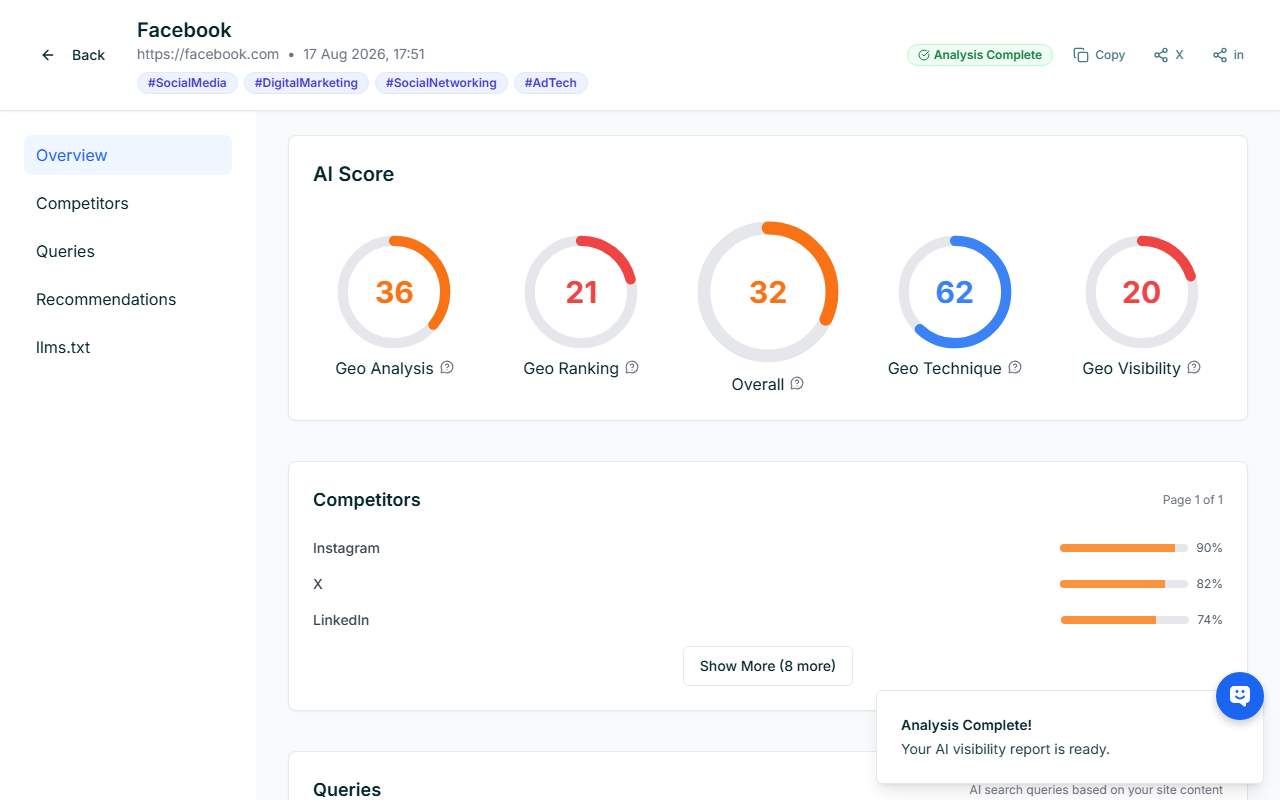
- AIビジビリティ・スコアの測定:競合と比較して、自社がどれほどの頻度でAIの回答に引用されているかを数値化。
- プロンプト分析:どのような質問文の際に自社サイトがソースとして選ばれているのかを特定。
- ギャップ分析:競合他社が引用されていて、自社が引用されていない理由と改善策を提示。
GeoCheck.aiを活用することで、感覚的なSEO対策から脱却し、データに基づいた確実なAI検索最適化を実現できます。
5. Perplexity AIの引用を獲得し続けるための実践的GEO戦略
Perplexityのインデックスと引用の仕組みを踏まえ、明日から実践できる具体的なGEO戦略をまとめました。
1. 「逆引き」しやすいQ&A構造の強化
Perplexityを使うユーザーは、「〜の違いは何?」「おすすめの〜を教えて」といった具体的な質問を投げかけます。記事内に明確なH2/H3見出しを設け、その直下に結論を端的に記述する「回答ファースト」の構成を徹底しましょう。
2. 一次情報と独自データの投入
AIはネット上のありふれた情報の要約を繰り返す傾向にあります。そのため、自社で取得したアンケートデータ、専門家のインタビュー、独自のケーススタディといった「一次情報」が含まれているページは、AIにとって代え難い強力な引用ソースとなります。
3. テクニカルSEOとrobots.txtの最適化
PerplexityBotなどのAIクローラーがアクセスしやすい環境を整えます。過剰なスクレイピングブロックはAIからの引用機会を自ら失う原因になるため、自社コンテンツをどのAIにインデックスさせるべきか、戦略的なアクセス許可を行いましょう。
4. 継続的なAI可視性のモニタリング
AIのアルゴリズムは頻繁にアップデートされます。先週引用されていた記事が、今週は引用されなくなることも珍しくありません。GeoCheck.aiのような専用ツールを用いて定期的に監査を行い、AIトレンドの変化に素早く適応していくことが、持続的なトラフィック獲得の鍵となります。
まとめ
Perplexity AIの検索インデックスと引用の仕組みは、従来の検索エンジンの延長線上にありながらも、「文脈の理解」と「情報の正確な合成」においてより高度な進化を遂げています。
キーワードを詰め込むだけの古いSEO手法は通用しなくなりました。今後は、AIにとって「最も信頼でき、要約しやすく、引用する価値のある情報源」として認知されることが不可欠です。
自社のAI検索におけるプレゼンスを正確に把握し、競合の一歩先を行くために、今すぐGeoCheck.aiを活用したGEO戦略の第一歩を踏み出しましょう。AI時代の検索覇権を握るのは、変化の仕組みをいち早く理解し、最適化をやりきった企業です。